6言語で同じ動きを再現したら、正解に対する再現率は約49%だった
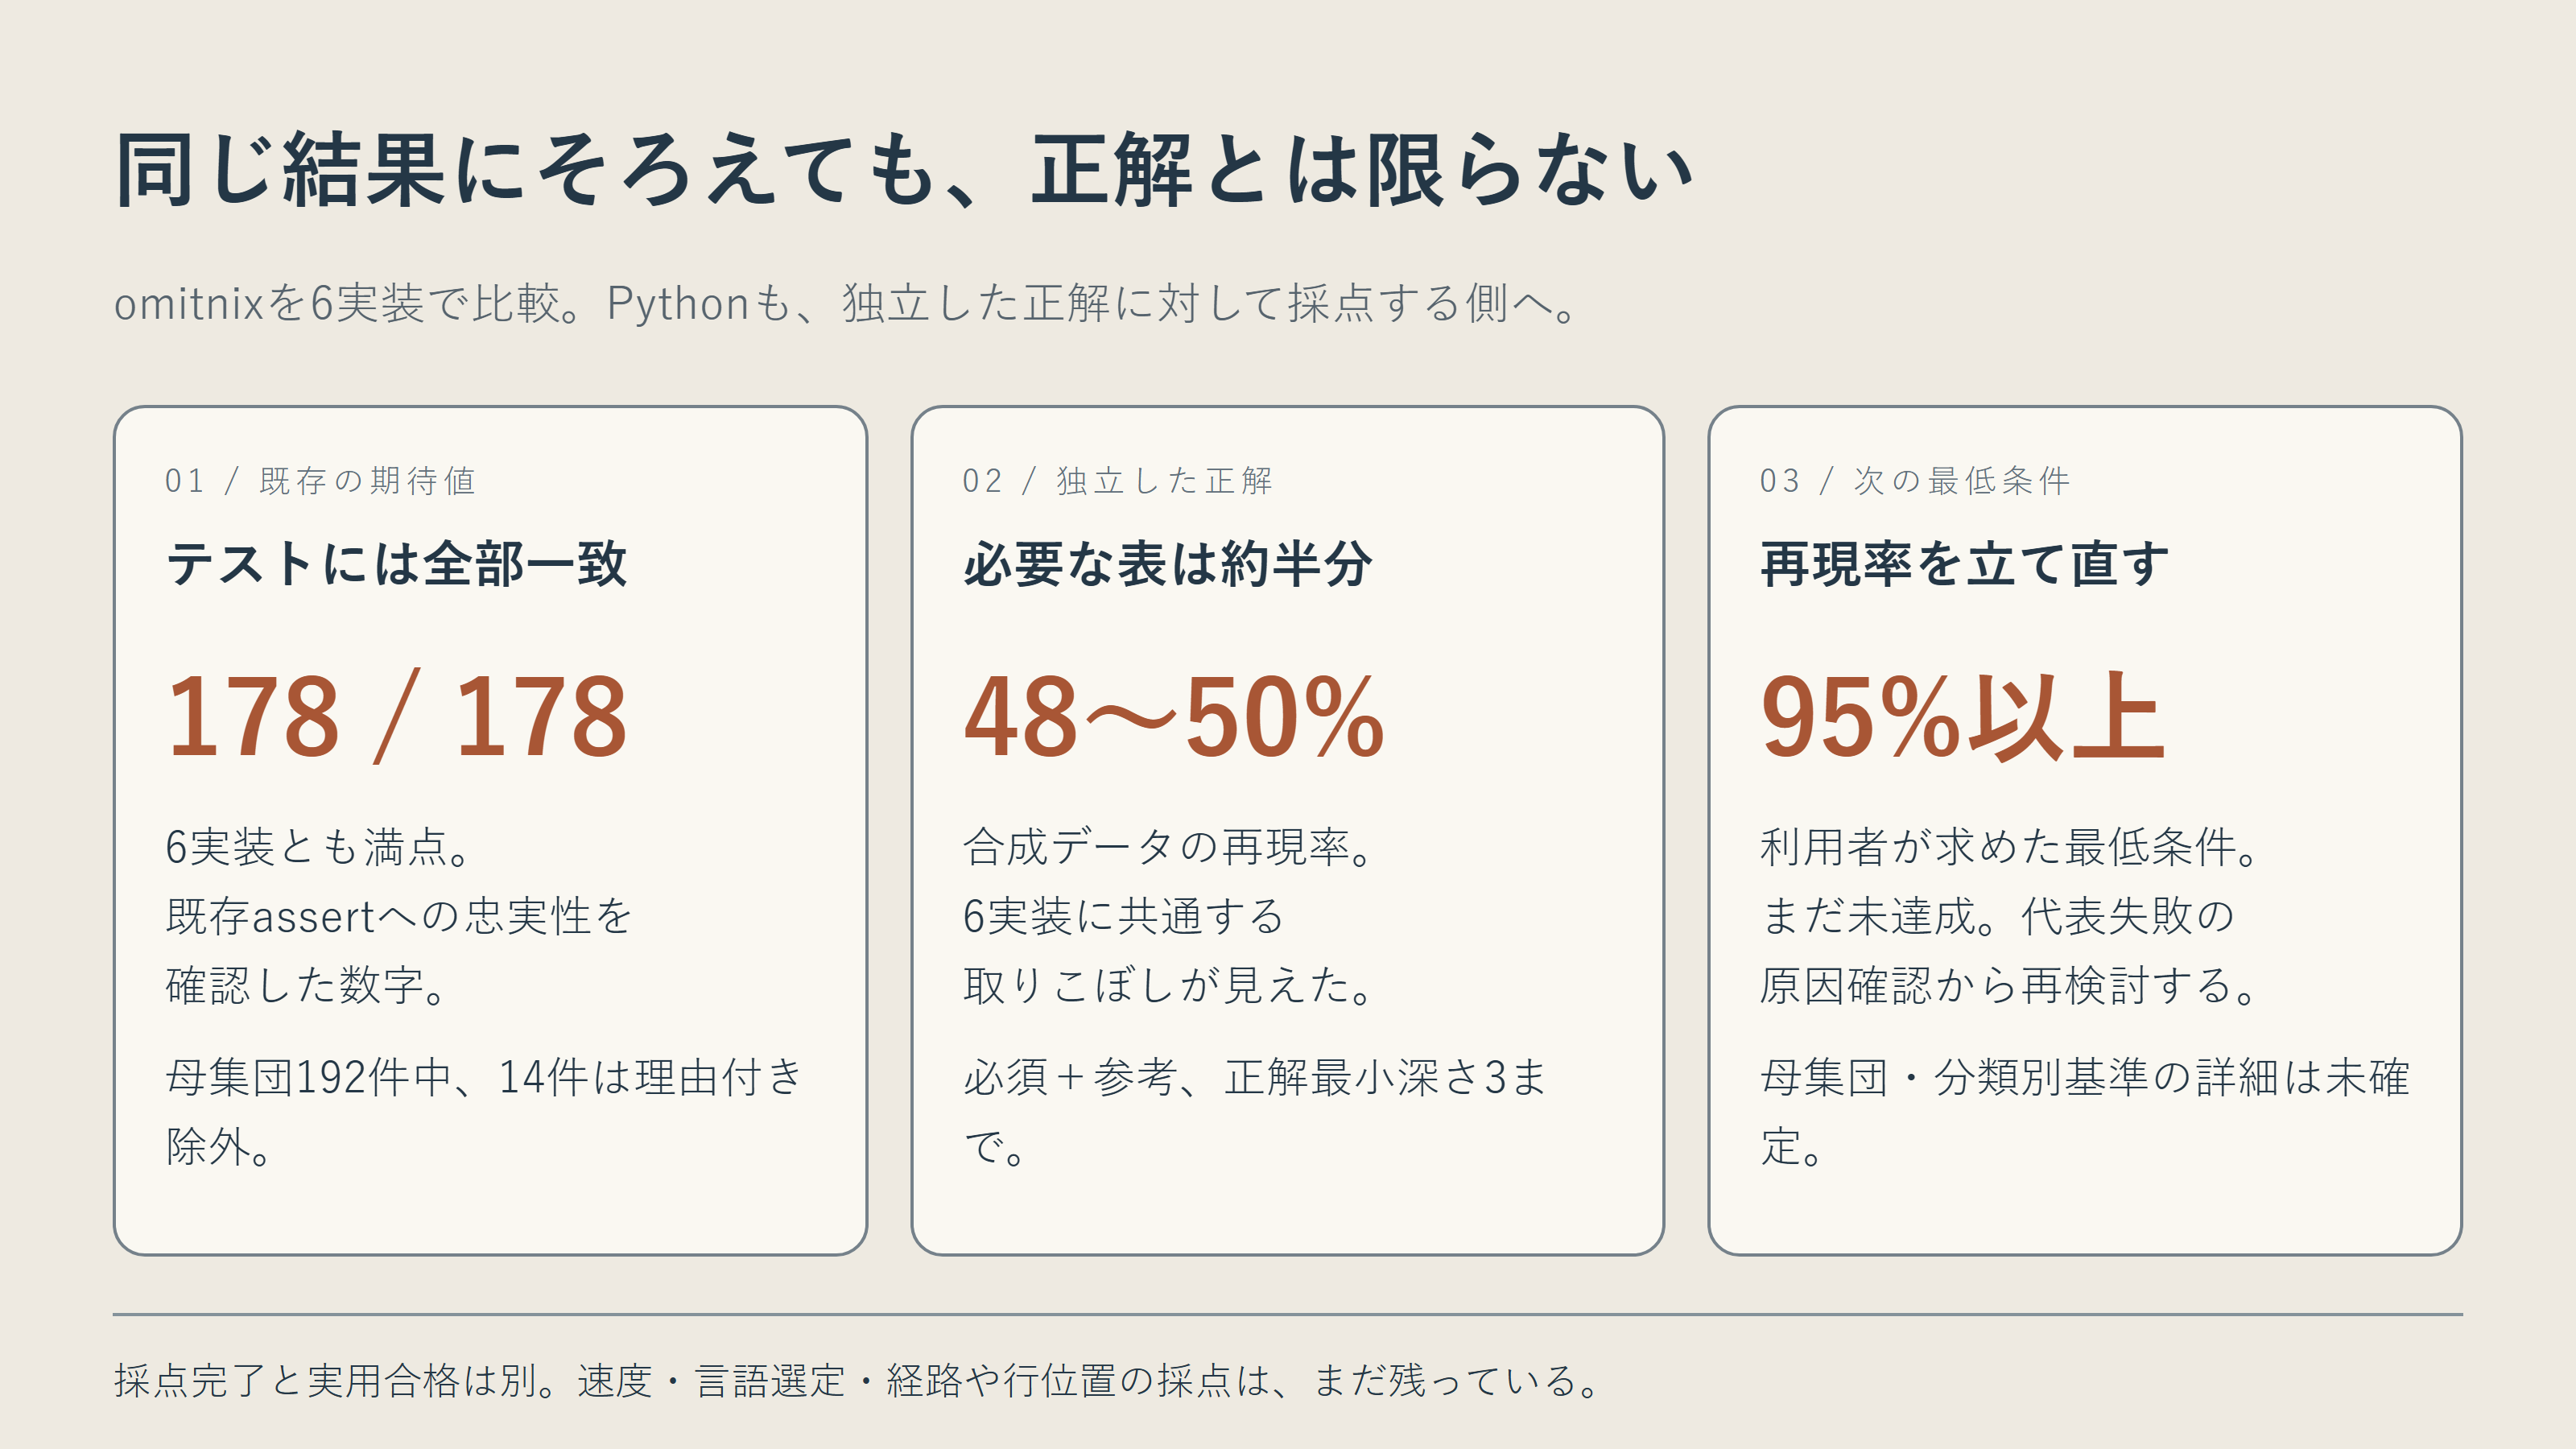
既存テストから取り出した178件の期待値に、6つの実装が全部通りました。ところが独立した正解データで静的解析の再現率を測ると、約49%でした。AIエージェントと進めていた多言語への書き換えで、比べる基準を取り違えていたことが見えてきました。
満点は、正しさの証明ではなかった
テストが測っていたのは「既存の実装と同じ答えを返すか」でした。正解に対して必要な表をどれだけ拾えているかは、別の物差しで測る必要がありました。この記事では、その物差しを独立して用意し、6実装を採点し直しています。
再現率と適合率を分けて見る
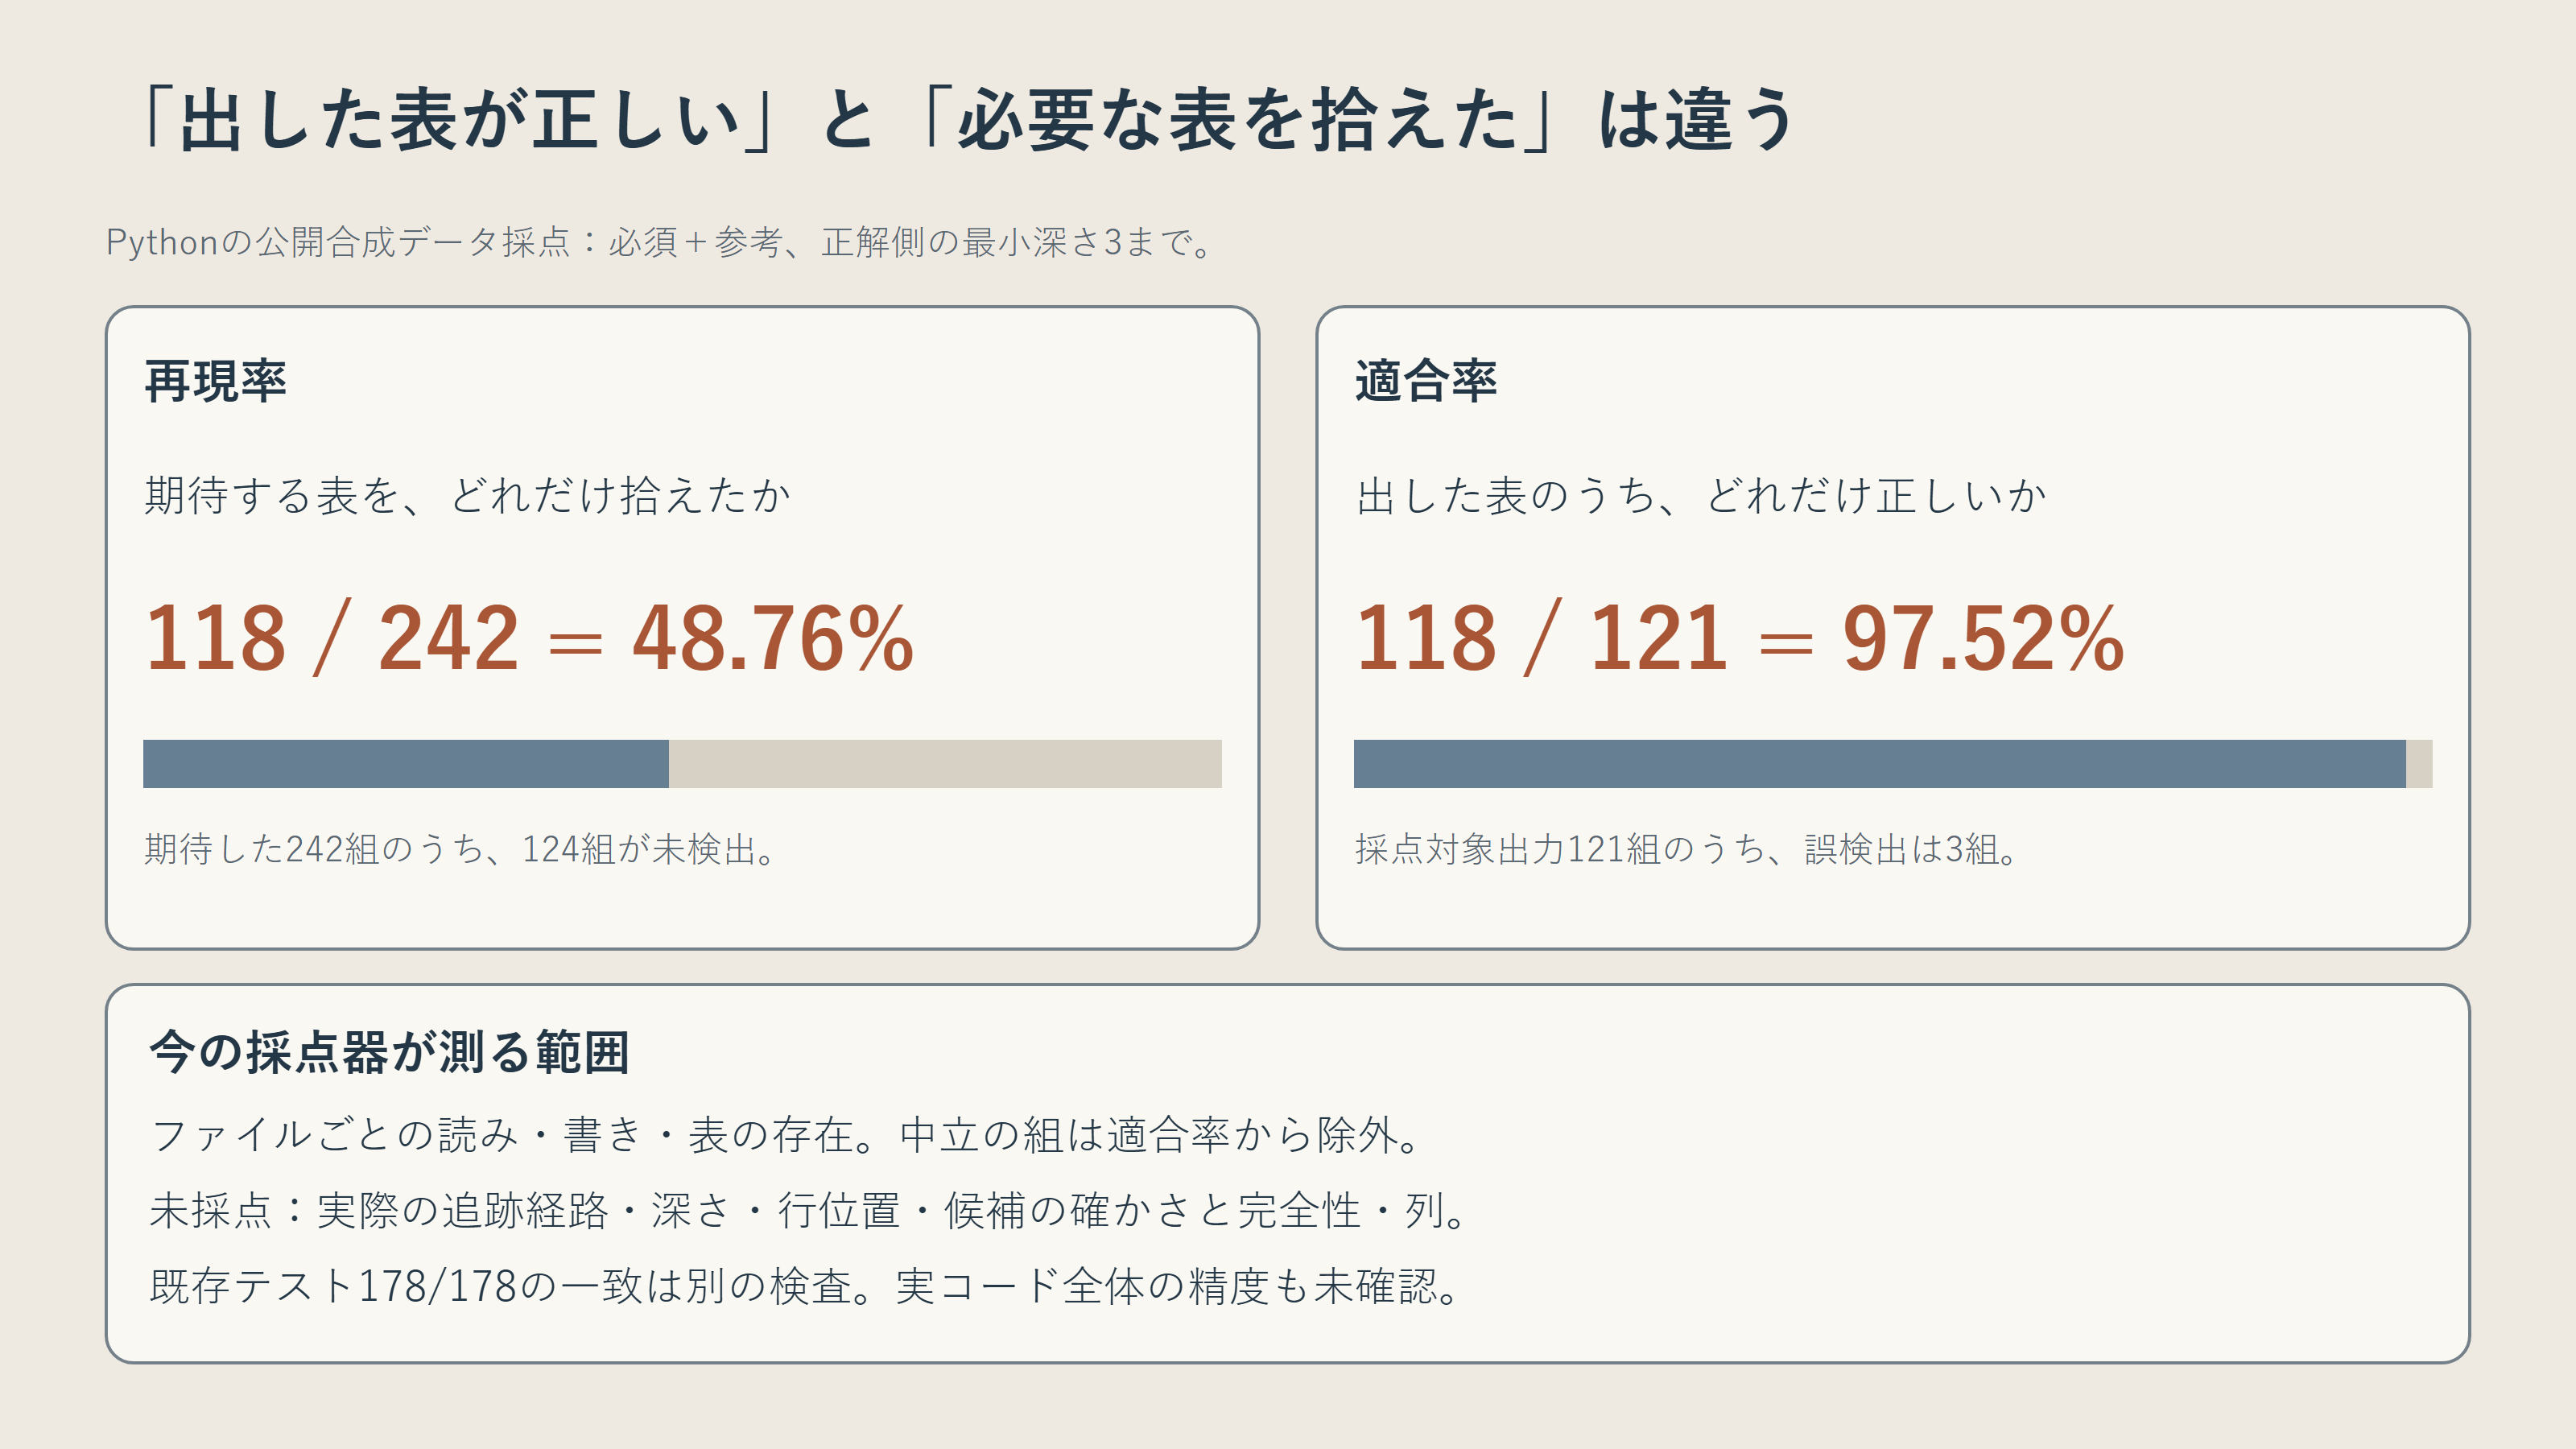
拾うべきものをどれだけ拾えたかが再現率、拾ったもののうち正しかった割合が適合率です。今回の採点範囲と、2つの指標の違いを図にまとめました。
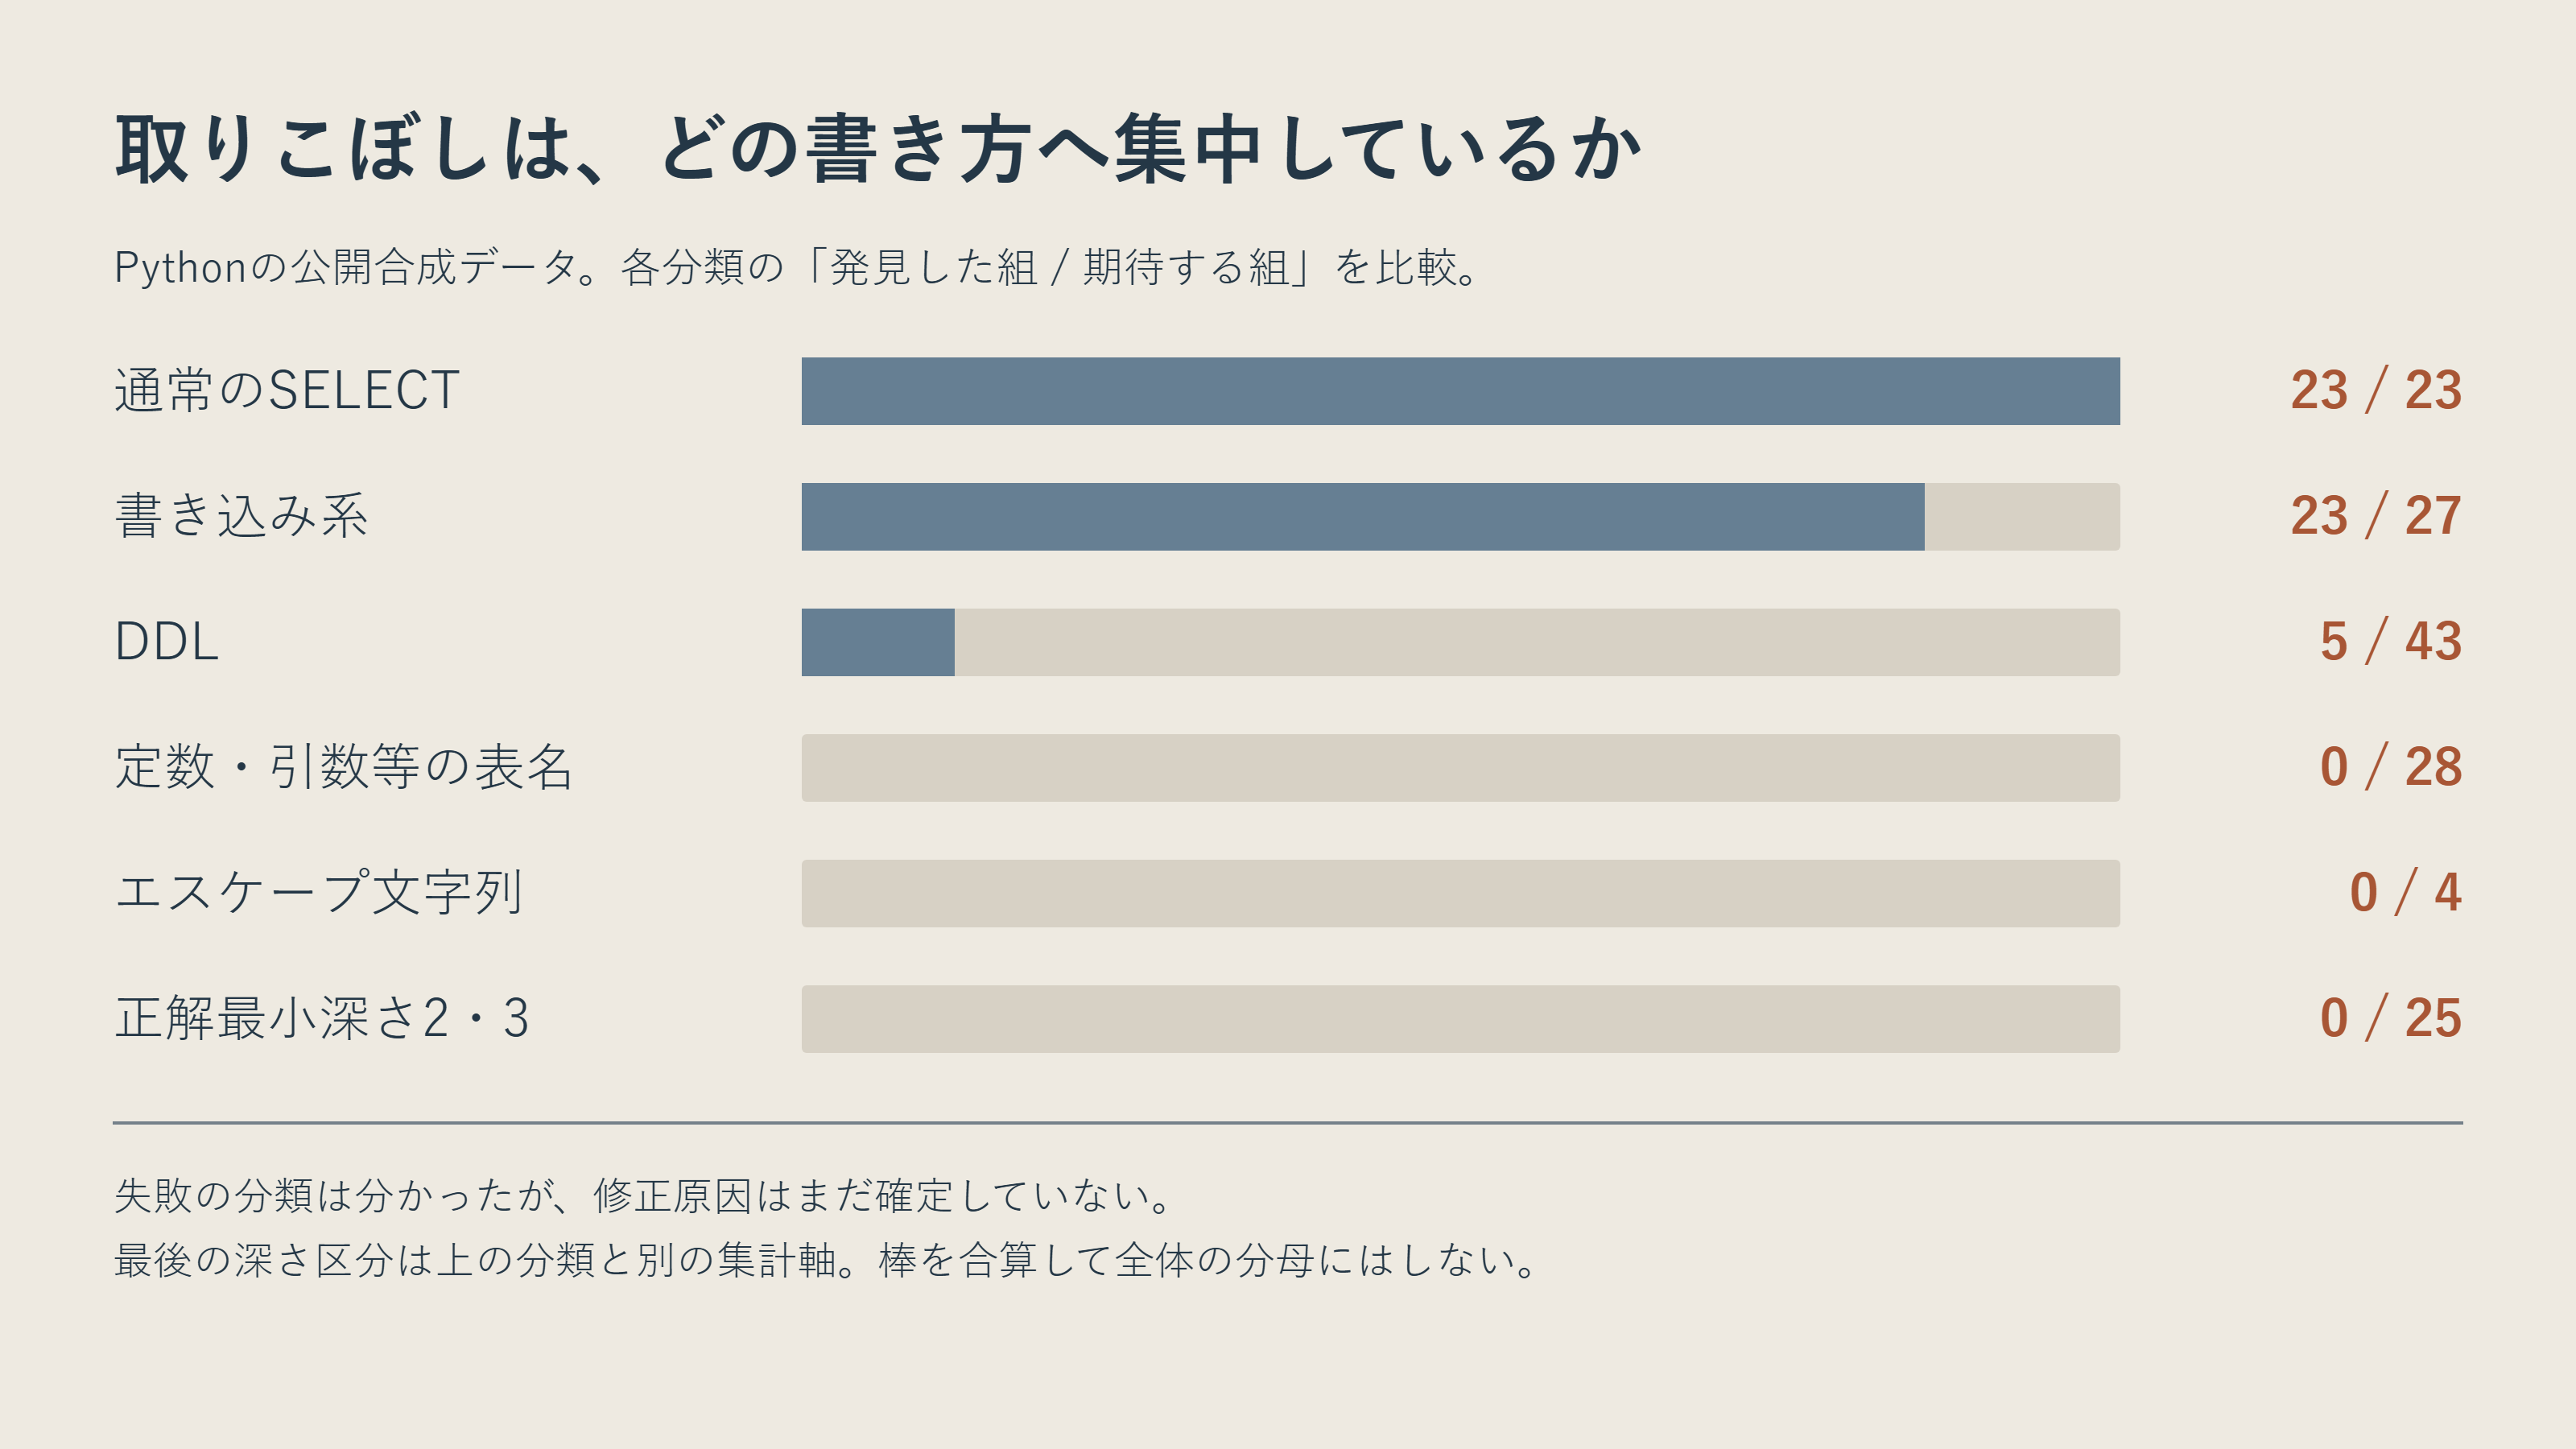
取りこぼしは、分類ごとに偏っていた
Pythonの分類別結果では、通常のSELECTは23/23でしたが、DDLは5/43、定数などを経由する表名は0/28でした。ただし今回の採点器が測るのは主に表の存在で、合成データの成績を実コード全体へそのまま広げることはできません。
これは改善完了の記事ではありません。基準を見直したことで、まだ実用に足りないと分かった時点の記録です。結果と未確認の範囲、次の調査手順は、Qiita本文にまとめています。